
PYTHON EĞİTİM SERİSİ · DERS 07 / 16
Küçük bir Python atölyesi düzenlediğimizi düşünelim. Katılımcıların adlarını kaydediyor, her birine kısa bir kayıt kodu veriyor ve atölyeye gelenleri işaretliyoruz. Gün sonunda iki soruya cevap vermek istiyoruz: Belirli bir kod kime ait ve kayıtlı kişilerden hangileri henüz gelmedi?
Bir önceki derste öğrendiğimiz listelerle bu bilgileri saklayabiliriz. Ancak kodları bir listede, adları başka listede tutarsak iki listenin sırasını sürekli eşleştirmemiz gerekir. Birinden öğe silip diğerini unutmak, yanlış adı yanlış kodla göstermemize yol açabilir. Veriler arasındaki ilişkiyi daha açık kurabileceğimiz bir yapıya ihtiyacımız var.
Bu derste sözlüklerle bir anahtarı bir değere bağlayacak, kümelerle benzersiz öğeler üzerinde çalışacağız. Yalnızca süslü parantez yazmayı değil, bir kaydı nasıl bulacağımızı, aynı öğe tekrar geldiğinde ne olacağını ve hangi bilgiyi korumamız gerektiğini öğreneceğiz. Son bölümde bu iki yapıyı çalışan bir katılım programında birleştireceğiz.
Örnekleri sozlukler_kumeler.py dosyasında ayrı ayrı deneyebilirsiniz. Her Python kutusu kendi başlangıç verisini içerir. Çıktı kutuları programın ürettiği sonucu gösterir; bunları kod dosyasına eklemeyin. Bilerek hatalı olduğu belirtilen örnekleri diğerlerinden ayrı çalıştırın.
Önce ihtiyacı belirleyelim: Sıra mı, eşleştirme mi, benzersizlik mi?
Bir veri yapısını seçerken önce hangi soruyu soracağımıza bakmak işimizi kolaylaştırır. “İlk kayıt hangisi?” sorusu ile “A17 kodlu kayıt hangisi?” sorusu aynı değildir. İlkinde konum, ikincisinde anlamlı bir anahtar kullanıyoruz. “Kaç farklı kişi geldi?” sorusunda ise tekrarların nasıl değerlendirileceği önem kazanır.
Atölye örneğimizde kayıt kodu ile katılımcı adı arasındaki eşleştirme için sözlük uygundur. Katılımı işaretlemek için yalnızca gelenlerin kodlarını saklayabiliriz. Aynı kişinin iki kez işaretlenmesi toplamı artırmasın istiyorsak burada küme kullanmak anlaşılır bir çözümdür.
| Yapı | Bu dersteki kullanım amacı | Örnek |
|---|---|---|
| Liste | İşlem sırasını ve tekrarları korumak | Gelen başvuruların tamamı |
| Demet | Belirli sıradaki değerleri birlikte taşımak | Atölye adı ve süresi |
| Sözlük | Anahtarı bir değere bağlamak | Kayıt kodundan katılımcıyı bulmak |
| Küme | Benzersiz öğeleri ve grup ilişkilerini tutmak | Gelenlerin farklı kayıt kodları |
Bu tablo, aynı problemin yalnızca tek doğru veri yapısıyla çözülebileceğini söylemiyor. Örneğin katılımcıların geliş saatlerini de tutmak isteseydik yalnızca kodlardan oluşan bir küme yeterli olmazdı. Seçimi, programın saklaması gereken bilgiye göre yapıyoruz; yapıyı seçtikten sonra problemi ona uydurmuyoruz.
Sözlük oluşturma: Anahtar ve değer birlikte çalışır
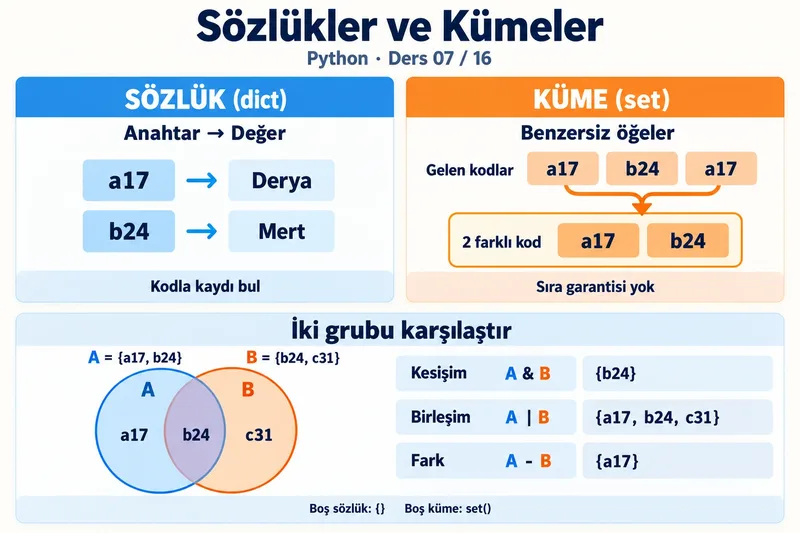
Python’da sözlük, yani dict, anahtarlarla değerler arasındaki eşleştirmeleri tutar. Atölyemizde anahtar kayıt kodu, değer ise katılımcının adı olabilir. Bir kayıt içindeki anahtar ile değeri iki nokta, kayıtları birbirinden virgül ayırır:
kayitlar = {
    "a17": "Derya",
    "b24": "Mert",
}

print(kayitlar["a17"])
print(len(kayitlar))
Çıktı:
Derya
2
Burada kayitlar["a17"], listedeki belirli bir sıraya gitmiyor. Sözlükte bu anahtara bağlı değeri istiyor. len() ise iki anahtar-değer eşleştirmesi bulunduğunu söylüyor. Ad ve kodu ayrı ayrı dört öğe olarak saymıyoruz.
Anahtarları metin olarak seçmemiz bilinçli bir tercih. Kayıt kodu bir hesaplama miktarı değildir; içinde harf olabilir ve başındaki sıfırlar anlam taşıyabilir. Örneğin "007" ile "7" farklı metin anahtarlarıdır. Gerekmedikçe kodları sayıya çevirmemek, bu ayrımı korumamıza yardımcı olur.
Boş sözlük için {} veya dict() kullanabiliriz. Programın başında hiç katılımcı olmayacaksa boş başlatmak doğaldır. Başlangıç verisini gerçek kullanıcılardan alacağımız bir örnekte, yalnızca kodun çalışması için rastgele katılımcılar eklemek zorunda değiliz.
Var olan kaydı değiştirmek ve yeni kayıt eklemek
Sözlükte köşeli parantezle atama yaparken anahtarın daha önce bulunup bulunmaması sonucu değiştirir. Yeni bir anahtar yeni eşleştirme oluşturur; mevcut anahtara atama ise onun değerini değiştirir. Bunu kayıt sayısıyla birlikte gözleyelim:
kayitlar = {"a17": "Derya"}
kayitlar["b24"] = "Mert"
kayitlar["a17"] = "Derya Deniz"

print(kayitlar)
print(len(kayitlar))
Çıktı:
{'a17': 'Derya Deniz', 'b24': 'Mert'}
2
Aynı anahtar için iki ayrı katılımcı oluşmadı. Bu davranış, isim düzeltmek istediğimizde yararlıdır. Ancak yanlışlıkla başka kişinin kodunu tekrar kullanırsak önceki adı değiştirebiliriz. Program hata vermediği için kayıtların doğru olduğuna karar vermemeliyiz; uygulamanın ekleme ve güncelleme kurallarını ayrıca tasarlamalıyız.
Birden fazla alanı birlikte eklemek veya değiştirmek için update() kullanılabilir. Bu yöntem de mevcut anahtarların değerlerini değiştirebilir. Örneğin ayarlar.update({"ses": False, "tema": "koyu"}), yalnızca yeni anahtar ekleyen bir işlem olarak düşünülmemelidir. İşlemden önce hangi alanların zaten var olduğunu değerlendirin.
Eksik anahtarı okumak: Köşeli parantez ve get() farkı
Atölye masasında olmayan bir kod sorulduğunda programın ne yapacağına karar vermemiz gerekir. Normal bir sözlükte bulunmayan anahtarı doğrudan okumak KeyError oluşturur. Aşağıdaki örnek bilerek hatalıdır:
kayitlar = {"a17": "Derya"}
print(kayitlar["z99"])
Bu örnekte sorun sözlüğün boş olması değildir. Sözlükte bir kayıt vardır, fakat istediğimiz anahtar bulunmaz. Bir veri yapısında herhangi bir bilginin bulunmasıyla aradığımız belirli bilginin bulunmasını ayrı değerlendirmek gerekir.
Eksik kayıt beklenen bir durumsa get() ile varsayılan sonuç belirleyebiliriz:
kayitlar = {"a17": "Derya"}

print(kayitlar.get("a17", "Kayıt yok"))
print(kayitlar.get("z99", "Kayıt yok"))
print("z99" in kayitlar)
Çıktı:
Derya
Kayıt yok
False
get() burada sözlüğe "z99" kaydını eklemedi; yalnızca anahtar bulunmadığında kullanacağımız sonucu verdi. İkinci parametreyi yazmazsak eksik anahtar için None döner. Bu davranışların resmî tanımları Python sözlük belgelerinde bulunur.
Sıfır değeri ile olmayan anahtarı karıştırmayın
Bir atölyenin kontenjanı sıfır olabilir. Bu, kontenjan bilgisinin hiç girilmemesinden farklıdır. if kontenjanlar.get("python"): yazarsak sıfır da koşulda yanlış kabul edilir. Amacımız alanın varlığını denetlemekse doğrudan üyelik kontrolü kullanabiliriz:
kontenjanlar = {"python": 0}

if "python" in kontenjanlar:
    print(f"Kontenjan tanımlı: {kontenjanlar['python']}")
else:
    print("Kontenjan bilgisi yok.")
Çıktı:
Kontenjan tanımlı: 0Burada “değer var mı?”, “değer sıfır mı?” ve “yer kaldı mı?” farklı sorulardır. Önce neyi öğrenmek istediğimizi belirlemek, daha uzun koşullar yazmaktan çoğu zaman daha yararlıdır. Varsayılan mesajlarla gerçek verileri birbirine karıştırmamaya da dikkat edin.
in, keys(), values() ve items() hangi bilgiyi verir?
Bir sözlük üzerinde doğrudan in kullanıldığında anahtarlar denetlenir. Adın değer olarak bulunması, aynı metnin anahtar olarak da bulunduğu anlamına gelmez:
kayitlar = {"a17": "Derya", "b24": "Mert"}

print("a17" in kayitlar)
print("Derya" in kayitlar)
print("Derya" in kayitlar.values())
Çıktı:
True
False
True
Kodla katılımcı bulmak istiyorsak ilk kontrol doğrudur. Bir adın kayıtlı olup olmadığını araştırıyorsak değerlere bakmamız gerekir. Bununla birlikte adlar benzersiz olmayabilir. İki kişinin aynı adı taşıması mümkündür; bu nedenle adı bütün durumlarda kayıt kimliği gibi kullanmak güvenilir bir tasarım olmaz.
keys() anahtarları, values() değerleri, items() ise anahtar-değer çiftlerini dolaşmamızı sağlar. Hem kodu hem adı yazdırmak için sonuncusunu kullanabiliriz:
kayitlar = {"a17": "Derya", "b24": "Mert"}

for kod, ad in kayitlar.items():
    print(f"{kod}: {ad}")
Çıktı:
a17: Derya
b24: Mert
Önceki derste demetleri değişkenlere açmıştık. Burada her turda gelen iki öğeli çiftin parçalarını kod ve ad değişkenleri alıyor. Böylece anahtarı öğrendikten sonra aynı değeri ayrıca aramamıza gerek kalmıyor. Döngü akışı için for ve while dersimizi hatırlayabilirsiniz.
Bu yöntemlerin verdiği görünümleri bağımsız yedeklerle karıştırmayın. Örneğin bir keys() görünümü sakladıktan sonra sözlüğe kayıt eklerseniz görünüm yeni anahtarı da yansıtır. O anki anahtarların ayrı bir listesini istiyorsanız list(kayitlar) oluşturabilirsiniz. Bunun, sözlüğün bütün içeriğinin derin kopyası olmadığını unutmayın.
Sözlüklerde sıra vardır, fakat bu otomatik sıralama değildir
Python 3.7 ve sonrasında sözlükler ekleme sırasını korur. Bir anahtarın değerini değiştirmek onu sona taşımaz. Anahtarı silip yeniden eklerseniz ise yeni ekleme konumu sona gelir. Buradaki sıra, anahtarların alfabetik veya sayısal olarak sıralanması anlamına gelmez.
kayitlar = {"b24": "Mert", "a17": "Derya"}

print(list(kayitlar))
print(sorted(kayitlar))
print(list(kayitlar))
Çıktı:
['b24', 'a17']
['a17', 'b24']
['b24', 'a17']
sorted(kayitlar) bu örnekte anahtarları sıralayan yeni bir liste üretti; sözlüğün ekleme sırasını değiştirmedi. Katılımcı raporunu kod sırasıyla göstermek istediğimizde bu ayrım işimize yarar. Kayıt ekleme sırası ile raporlama sırası farklı ihtiyaçlardır ve ikisini aynı anda koruyabiliriz.
Kayıt silmek: del ve pop() arasında seçim yapmak
Kaydı kaldırmak istediğimizde anahtarın bulunup bulunmadığını değerlendirmeliyiz. del kayitlar["a17"] ilgili eşleştirmeyi siler; anahtar yoksa hata verir. Kaldırılan değeri de kullanmak istiyorsak pop() daha uygun olabilir:
kayitlar = {"a17": "Derya", "b24": "Mert"}
silinen_ad = kayitlar.pop("a17", "Kayıt bulunamadı")

print(silinen_ad)
print(kayitlar)
print(kayitlar.pop("z99", "Kayıt bulunamadı"))
Çıktı:
Derya
{'b24': 'Mert'}
Kayıt bulunamadı
İlk işlemde kayıt çıkarıldı ve adı ayrı değişkende kullanıldı. Son işlemde eksik anahtar için verdiğimiz varsayılan metin döndü. Varsayılan parametre olmadan eksik anahtara pop() uygulamak da KeyError oluşturur. Sözlüğün pop() yöntemiyle önceki dersteki liste pop() yönteminin parametrelerini karıştırmayın: Burada konum yerine anahtar veriyoruz.
Anahtar seçerken hashable ne anlama gelir?
Anahtarlar için yalnızca metin kullanılmaz; tam sayılar ve uygun demetler de kullanılabilir. Temel koşul, anahtarın hashable olmasıdır. Başlangıç için metin ve tam sayıların uygun olduğunu, liste ve sözlüklerin ise anahtar olamayacağını bilmek yeterlidir. Kavramın teknik tanımı Python terimler sözlüğünde açıklanır.
Aşağıdaki örnek bilerek hatalıdır:
kayitlar = {}
kayitlar[["a17"]] = "Derya"
Burada köşeli parantezle oluşturulan listeyi anahtar yapmaya çalıştığımız için TypeError oluşur. “Demetler değiştirilemez, o halde her demet anahtar olur” genellemesi de doğru değildir. İçinde liste bulunan bir demet bu koşulu sağlamaz. İleride karmaşık anahtarlar kullanırken yalnızca dış paranteze bakmayacağız.
Anahtarların eşitlik davranışı da önemlidir. Örneğin 1, 1.0 ve True, sözlükte ayrı üç kayıt anahtarı gibi kullanılmaz; birbirine eşit kabul edilirler. Atölyemizde bütün kodları metin tutmak, farklı türlerden gelen bu tür karışıklıkları azaltır. Bu, Python’un zorunluluğu değil, kendi veri modelimiz için seçtiğimiz tutarlı bir kuraldır.
İç içe sözlükler ve kopyalamanın sınırı
Bir katılımcıya tek bir ad yerine ad ve atölye bilgisi bağlamak istediğimizde değerin kendisi de sözlük olabilir. Değerler anahtarlarla aynı türde olmak zorunda değildir. Ancak iç içe yapı kurduğumuzda kopyalama davranışını daha dikkatli değerlendirmeliyiz:
kayit = {"ad": "Derya", "konular": ["python"]}
kopya = kayit.copy()
kopya["konular"].append("veri")

print(kayit["konular"])
print(kopya["konular"])
Çıktı:
['python', 'veri']
['python', 'veri']
Dış sözlük ayrı olsa da içerideki liste ortaktır. Bu nedenle kopyaya konu eklediğimizi düşünürken özgün kayıtta da değişiklik gördük. copy() burada sığ kopya üretmiştir. Ayrıca kopya = kayit yazsaydık dış sözlük bile ayrı olmayacaktı; iki değişken aynı sözlüğe bağlı kalacaktı.
Bu derste bütün katmanları kopyalayacak bir çözüm kurmamız gerekmiyor. Önemli olan, hangi nesnenin paylaşıldığını anlayabilmek. Daha ayrıntılı açıklama için Python’un kopyalama belgesine bakabilirsiniz. Ana uygulamamızda değerleri metin tutarak bu ek katmanı programın merkezine taşımayacağız.
Sözlüğü sayaç olarak kullanmak
Sözlükler yalnızca kişi veya ürün kayıtlarına uygun değildir. Bir başvuru listesindeki konu adlarının kaç kez geçtiğini de anahtar-değer ilişkisiyle tutabiliriz. Anahtar konu adı, değer ise o ana kadar hesaplanan adet olur:
basvurular = ["python", "web", "python", "veri", "web", "python"]
sayac = {}

for konu in basvurular:
    sayac[konu] = sayac.get(konu, 0) + 1

print(sayac)
Çıktı:
{'python': 3, 'web': 2, 'veri': 1}İlk kez gördüğümüz konu için get() sıfır verir; buna bir ekleyip sözlüğe yazarız. Sonraki karşılaşmada mevcut sayı üzerinden ilerleriz. Başlangıç sözlüğünü döngünün içinde yeniden oluştursaydık önceki sayımları kaybederdik. Değişkeni nerede başlattığımız, hangi bilgiyi koruduğumuzu belirler.
Bu sayım, yazılışları aynı olan metinleri birleştirir. "Python", "python" ve " python " kendiliğinden aynı konu sayılmaz. Veriyi temizleme kararı sayma işleminden ayrıdır. Büyük-küçük harf ve boşluk davranışını Metin İşlemleri dersindeki yöntemlerle değerlendirebilirsiniz; dil kurallarını düşünmeden bütün metinleri dönüştürmeyin.
Küme oluşturma: Tekrarları bir kez tutmak
Küme, yani set, benzersiz öğeleri tutar. Aynı kayıt kodunu ikinci kez eklediğimizde aynı öğe için yeni bir yer oluşmaz. Katılımcının kaç kez işaretlendiği yerine katılıp katılmadığı önemliyse bu davranış işimize yarar:
gelenler = {"a17", "b24", "a17"}

print(len(gelenler))
print("a17" in gelenler)
print(sorted(gelenler))
Çıktı:
2
True
['a17', 'b24']
Çıktıda doğrudan kümeyi değil, sorted() ile oluşturduğumuz listeyi gösterdik. Böylece ekranda takip edilebilir bir kod sırası elde ediyoruz. Kümenin kendisi ekleme sırasını veya indeksleri saklama sözü vermez. Bazı çalıştırmalarda aynı görünümü almanız, o sıraya güvenebileceğiniz anlamına gelmez.
Boş küme için set() kullanılır. {} boş sözlüktür. Her ikisinde süslü parantez görmemiz aynı tür oldukları anlamına gelmez. Ayrıca küme öğeleri de hashable olmalıdır; listeleri doğrudan küme öğesi yapamayız. Temel davranışları resmî küme belgelerinde inceleyebilirsiniz.
Kümeden ilk öğeyi indeksle istemeyin
gelenler[0] yazarak “ilk gelen kişiyi” bulamayız. Kümeler indeksleme ve dilimleme sağlamaz; bu girişim TypeError verir. İlk geliş sırası uygulamanın önemli bilgisi olacaksa bunu ayrıca listede veya uygun başka bir kayıt yapısında tutmalıyız.
Benzer biçimde bir başvuru listesini kümeye çevirdiğimizde tekrarların kaç kez geçtiği bilgisini kaybederiz. Yalnızca farklı başvuru türlerini istiyorsak bu uygundur; toplam başvuru sayısını veya geliş sırasını da raporlayacaksak özgün listeyi korumamız gerekir. Veri temizlerken silinen bilginin daha sonra gerekip gerekmeyeceğini düşünün.
add(), update(), remove() ve discard() ile çalışmak
Bir öğe eklemek için add(), birden fazla öğeyi eklemek için update() kullanabiliriz. Silme tarafında ise eksik öğeye nasıl davranmak istediğimiz önemlidir. remove() bulunmayan öğede hata verirken discard() bu durumda hata üretmez:
gelenler = set()
gelenler.add("a17")
gelenler.add("a17")
gelenler.update(["b24", "c31"])
gelenler.remove("b24")
gelenler.discard("z99")

print(sorted(gelenler))
Çıktı:
['a17', 'c31']discard() kullanmak her hatayı saklamamız gerektiği anlamına gelmez. Örneğin kullanıcı kaldıracağı kişiyi yanlış yazdıysa ona “işlem başarılı” demek yanıltıcı olabilir. İşlemden önce in ile kontrol edip uygun mesaj üretebiliriz. Seçeceğimiz yöntem, eksik öğenin normal bir durum mu yoksa kullanıcıya bildirilmesi gereken bir sorun mu olduğuna bağlıdır.
Bir başka ayrıntı: update("a17"), metni tek kod olarak eklemek yerine karakterlerini öğe olarak işler. Tek kayıt kodu eklemek için add("a17"), birden fazla kod için update(["a17", "b24"]) kullanırız. Önceki dersteki tek öğe ile öğeler topluluğu ayrımı burada da karşımıza çıkar.
İki grubu karşılaştırmak: Kesişim, birleşim ve fark
Birinci gün ile ikinci gün gelenleri karşılaştırdığımızda yalnızca kaç kişi olduğunu öğrenmek yetmez. İki günde de gelenleri, en az bir gün gelenleri veya yalnızca birinci gün gelenleri ayrı sorular olarak düşünebiliriz. Küme işlemleri bu soruları doğrudan ifade etmemizi sağlar:
ilk_gun = {"a17", "b24"}
ikinci_gun = {"b24", "c31"}

print(sorted(ilk_gun & ikinci_gun))
print(sorted(ilk_gun | ikinci_gun))
print(sorted(ilk_gun - ikinci_gun))
print(sorted(ilk_gun ^ ikinci_gun))
Çıktı:
['b24']
['a17', 'b24', 'c31']
['a17']
['a17', 'c31']
& kesişimi, | birleşimi, - farkı, ^ ise simetrik farkı verir. Sonuncusu iki gruptan yalnızca birinde bulunanları seçer. İki günde de gelen kişi burada bulunmaz. İşaretleri ezberlemek yerine her satırı doğal dille okuyup beklediğiniz kodları önce kendiniz yazın.
Fark işleminin yönü önemlidir. ilk_gun - ikinci_gun ile ikinci_gun - ilk_gun aynı soruyu sormaz. Ana projemizde kayıtlılar kümesinden gelenler kümesini çıkararak henüz gelmeyenleri bulacağız. Tersini yazarsak aynı raporu elde etmeyiz.
Alt küme denetimi için <= kullanılabilir. gelenler <= kayitli_kodlar, gelen her kodun kayıtlı kodlar arasında bulunup bulunmadığını sorar. Sayısal büyüklük karşılaştırması yapmaz. İki küme eşitse sonuç yine doğrudur; yalnızca öğe sayılarını karşılaştırmak aynı bilgiyi vermez.
Sırayı koruyarak tekrarları ayıklamak
Bazen hem benzersizlik hem ilk görülme sırası gerekir. Örneğin atölyede önerilen konuları, ilk önerildikleri sırayı bozmadan göstermek isteyebiliriz. Yalnızca list(set(konular)) kullanmak bu sırayı garanti etmez. Daha önce gördüklerimizi kümede, sonucu listede tutabiliriz:
konular = ["web", "python", "web", "veri", "python"]
gorulenler = set()
benzersiz_konular = []

for konu in konular:
    if konu not in gorulenler:
        gorulenler.add(konu)
        benzersiz_konular.append(konu)

print(benzersiz_konular)
print(konular)
Çıktı:
['web', 'python', 'veri']
['web', 'python', 'web', 'veri', 'python']
Burada kümenin sırasından yararlanmıyoruz; sıralamayı listeye ekleme anımız belirliyor. Özgün liste de değişmedi. İki yapının farklı güçlü yanlarını aynı küçük işlemde kullandık. Öğelerin bu örnekte metin olması önemlidir; liste gibi hashable olmayan öğeler için aynı kodu doğrudan kullanamayız.
Sıralı bir rapor başka bir ihtiyaçtır. sorted() yeni bir liste oluşturur, ancak özgün geliş sırasını geri getirmez. Metinleri sıralarken Türkçe sözlük sırasının kendiliğinden uygulanacağını da varsaymayın. Bu derste kodları ve basit konu adlarını gösteriyoruz; sorted() davranışı Python’un yerleşik fonksiyonlar belgesinde açıklanır.
Küçük proje: Atölye kayıt ve katılım programı
Şimdi sözlük ve kümeyi tek uygulamada birleştirelim. Katılımcıları kodlarıyla kaydedeceğiz, gelenleri işaretleyeceğiz ve henüz gelmeyenleri raporlayacağız. Kayıt silindiğinde katılım işaretini de kaldıracağız. Böylece yalnızca bir ekleme örneği değil, birbirine bağlı iki veri yapısını tutarlı kullanma örneği elde edeceğiz.
Program kod ve adları metin olarak alır. Menü seçimini de metin olarak karşılaştırır; henüz sayı dönüştürme veya try-except gerektirmez. Fonksiyonları bir sonraki dersimizde ele alacağımız için burada akışı bildiğimiz koşullar ve döngülerle kuruyoruz. Aşağıdaki kodu atolye_katilim.py adıyla UTF-8 biçiminde kaydedebilirsiniz:
kayitlar = {}
gelenler = set()

while True:
    print("\nATÖLYE KATILIMI")
    print("1 - Katılımcı kaydet")
    print("2 - Geldi olarak işaretle")
    print("3 - Raporu göster")
    print("4 - Kaydı sil")
    print("0 - Çıkış")
    secim = input("Seçiminiz: ").strip()

    if secim == "1":
        kod = input("Kayıt kodu: ").strip()
        ad = input("Katılımcı adı: ").strip()

        if not kod or not ad:
            print("Kod ve ad boş bırakılamaz.")
        elif kod in kayitlar:
            print("Bu kod zaten kayıtlı. Mevcut kayıt değiştirilmedi.")
        else:
            kayitlar[kod] = ad
            print(f"Kaydedildi: {kod} - {ad}")

    elif secim == "2":
        kod = input("Gelen kişinin kodu: ").strip()

        if kod not in kayitlar:
            print("Önce bu kodla katılımcı kaydetmelisiniz.")
        elif kod in gelenler:
            print("Bu katılımcı zaten geldi olarak işaretli.")
        else:
            gelenler.add(kod)
            print(f"Katılım işlendi: {kayitlar[kod]}")

    elif secim == "3":
        if not kayitlar:
            print("Henüz katılımcı kaydı yok.")
        else:
            beklenenler = set(kayitlar) - gelenler
            print(f"Kayıtlı: {len(kayitlar)} | Gelen: {len(gelenler)}")

            for kod in sorted(kayitlar):
                durum = "Geldi" if kod in gelenler else "Bekleniyor"
                print(f"{kod} - {kayitlar[kod]}: {durum}")

            print("Henüz gelmeyenler:")
            if beklenenler:
                for kod in sorted(beklenenler):
                    print(f"{kod} - {kayitlar[kod]}")
            else:
                print("Kayıtlı herkes geldi.")

    elif secim == "4":
        kod = input("Silinecek kayıt kodu: ").strip()

        if kod in kayitlar:
            silinen_ad = kayitlar.pop(kod)
            gelenler.discard(kod)
            print(f"Kayıt silindi: {silinen_ad}")
        else:
            print("Bu kodla kayıt bulunamadı.")

    elif secim == "0":
        print("Program kapatıldı.")
        break

    else:
        print("Geçerli bir seçim yapın.")
Program neden iki ayrı veri yapısı kullanıyor?
kayitlar sözlüğü “Bu kod kime ait?” sorusunun cevabını saklıyor. gelenler kümesi ise “Bu kod katıldı mı?” bilgisini tutuyor. Katılımı saymak için isimleri yeniden yazmıyor, aynı kodları kullanıyoruz. İki farklı kişi aynı adı taşısa bile kodları farklıysa ayrı kayıt olarak kalabiliyor.
Kayıt ekleme aşamasında mevcut anahtarın değerini değiştirmeyi özellikle engelledik. Bu programda “kaydet” yeni kişi eklemek demek; isim düzeltme ayrı bir özellik olabilir. Sözlüğün atama davranışını bilmek, uygulamanın hangi davranışı sunacağını kendiliğinden belirlemez. Bu kararı koşulla görünür hale getirdik.
Geldi işaretinden önce kayıt kontrolü yapıyoruz. Böylece sözlükte olmayan bir kodun katılım kümesine girmesini engelliyoruz. Bu kural korunursa gelenler, kayıtlı kodların alt kümesi olarak kalır. Silme işleminde discard() kullanmamız da aynı ilişkiyi korur: Katılımı işaretlenmiş kayıt silindiğinde eski kod kümede kalmaz.
Rapor bölümündeki set(kayitlar), sözlüğün anahtarlarından bir küme üretir; katılımcı adlarını almaz. Bundan gelenleri çıkardığımızda beklenen kodlar kalır. Raporu her istediğimizde yeniden hesapladığımız için daha önceki rapordan kalan eski bir sonucu kullanmayız. Kullanıcı yeni kayıt eklediğinde sonraki rapor bunu içerir.
durum = "Geldi" if kod in gelenler else "Bekleniyor" satırı koşullu ifadedir. Koşul doğruysa ilk metni, değilse ikinci metni seçip değişkene atar. Aynı karar ayrı bir if-else bloğuyla da yazılabilir. Burada yalnızca kısa durum metnini seçtiğimiz için tek satır halinde okunabilir kalıyor.
Örnek kullanım ve beklenen rapor
Önce 1 seçeneğiyle a17 koduna Derya, ardından b24 koduna Mert kaydedin. 2 seçeneğinde yalnızca b24 kodunu işaretleyin. Sonra 3 ile raporu açın. Menü satırları dışında rapor bölümü şöyle görünmelidir:
Kayıtlı: 2 | Gelen: 1
a17 - Derya: Bekleniyor
b24 - Mert: Geldi
Henüz gelmeyenler:
a17 - Derya
Şimdi b24 kodunu yeniden geldi olarak işaretleyin. Program uyarı vermeli ve gelen sayısı bir kalmalıdır. Ardından aynı kodu 4 ile silip raporu tekrar açın. Hem kayıt sayısı hem katılım sayısı değişmelidir. Bu ikinci deneme, yalnızca eklemenin değil silme ilişkisinin de doğru kurulduğunu anlamamızı sağlar.
Program kodları büyük-küçük harfe duyarlı karşılaştırır; a17 ve A17 farklı kayıtlardır. strip() yalnızca uçlardaki boşlukları temizler. Ayrıca bütün bilgiler bellektedir: Program kapanınca kayıtlar kaybolur. Bu çalışma bir dosya kaydı, gerçek yoklama doğrulaması veya çok kullanıcılı sistem sunmaz; veri yapılarının ilişkisini öğrenmek için hazırlanmıştır.
Sık yapılan hataları sonuç üzerinden teşhis etmek
Bir kod hata vermeden çalışsa bile yanlış rapor oluşturabilir. Özellikle sözlükteki anahtarı değiştirirken veya listeyi kümeye çevirirken hangi bilginin kaybolduğunu takip edin. Aşağıdaki işaretler, hatayı bütün programda aramak yerine belirli işleme odaklanmanıza yardımcı olur.
| Gözlenen durum | Önce kontrol edilecek nokta |
|---|---|
| Boş kümeye add() uygulanamıyor | {} ile sözlük mü oluşturdunuz? |
| Yeni kayıt önceki adı değiştirdi | Aynı anahtara yeniden atama yaptınız mı? |
| Aranan ad varken in sonucu False | Anahtarlarda mı, değerlerde mi arıyorsunuz? |
| Tek kod yerine karakterler eklendi | update() yöntemine doğrudan metin mi verdiniz? |
| Kayıt silindi ama gelen sayısı düşmedi | Katılım kümesindeki kod da kaldırıldı mı? |
| Kopya değişince özgün veri de değişti | İçteki liste veya sözlük ortak mı? |
Sözlüğü dolaşırken aynı sözlüğe anahtar eklemek veya ondan anahtar silmek de sorun oluşturabilir. Birden fazla kaydı koşula göre temizleyecekseniz önce silinecek anahtarları ayrı listede toplayıp sonra silmek başlangıç için anlaşılır bir yaklaşımdır. Ana projede silmeyi rapor döngüsünün içinde yapmıyoruz.
Küme metotlarının dönüş değerlerine de dikkat edin. gelenler = gelenler.add("a17") yazmak doğru ekleme biçimi değildir; add() kümeyi değiştirir ve None döndürür. Değişen nesne ile metodun dönüş değerini ayırın. Önceki derste liste append() yönteminde gördüğümüz düşünme alışkanlığı burada da geçerlidir.
Öğrendiklerinizi geliştirecek üç alıştırma
1. Kayıt adını düzeltme seçeneği ekleyin. Yeni bir menü seçeneğinde önce kodun varlığını kontrol edin. Varsa boş olmayan yeni adı alın ve mevcut değeri değiştirin. Katılım durumunun korunması gerekir. Henüz gelmemiş ve gelmiş birer katılımcıda deneyerek isim değişikliğinin kayıt sayısını artırmadığını kontrol edin.
Bu alıştırmada yeni bir kod üretmeyin ve eski kaydı silip ekleme yoluna gitmeyin. Amaç, anahtarın temsil ettiği kişinin aynı kaldığı bir güncellemeyi modellemek. Aynı adla iki farklı kod kaydedip yalnızca seçtiğiniz kodun adının değiştiğini de gözleyin. Böylece anahtar ile değer arasındaki ayrımı uygulamada pekiştirirsiniz.
2. Katılım işaretini geri alma seçeneği ekleyin. Yanlışlıkla geldi işaretlenen bir kodu katılım kümesinden çıkarın, fakat sözlükteki kaydını koruyun. Kod kayıtlı değilse başka, kayıtlı olup henüz işaretlenmemişse başka mesaj verin. İşlem sonrasında raporda kişi yeniden “Bekleniyor” görünmelidir.
Bu kez iki yapıdan yalnızca birini değiştiriyorsunuz. Kayıt silme seçeneğinin kodunu olduğu gibi kopyalamak, yanlışlıkla kişiyi tamamen kaldırmanıza yol açabilir. Önce işlem öncesi ve sonrası için beklenen kayıt sayısını ve gelen sayısını yazın. Sonra gerçek çıktıyı bu iki beklentiyle karşılaştırın.
3. İki oturumun ortak katılımcılarını raporlayın. Ayrı bir örnekte sabah ve öğleden sonra gelen kodları iki kümede tutun. Her ikisine katılanları kesişimle, yalnızca sabah gelenleri farkla bulun. Kümeler aynıyken, tamamen farklıyken ve biri boşken de sonuçları inceleyin.
Ekranda kodları düzenli göstermek için sorted() kullanabilirsiniz. Ancak sıralanmış görünümün geliş saatlerini göstermediğini açıklayabilmelisiniz. Bu alıştırmanın hedefi yalnızca bir işlem işaretini kullanmak değil, sorulan rapor sorusuyla doğru küme işlemini eşleştirmek. “Ortak”, “yalnızca” ve “en az birinde” ifadelerini ayrı ayrı değerlendirin.
Bu dersten sonra hangi noktaya geldik?
Artık bir kaydı sıradaki konumuyla değil anahtarıyla bulabilir, eksik anahtar durumunu değerlendirebilir ve sözlükteki çiftleri birlikte dolaşabilirsiniz. Kümelerle tekrarları bir kez tutmayı, iki grubun ortak veya farklı öğelerini bulmayı ve gerekli olduğunda sırayı ayrı bir listede korumayı da öğrendik.
Atölye programında bu bilgileri tek akışta kullandık. En önemli kazanım, iki veri yapısı aynı kayıt kodlarını paylaştığında bir değişikliğin diğerini nasıl etkilemesi gerektiğini düşünmek. Programın doğru olması, yalnızca ekranın açılması değil; ekleme, tekrar işaretleme, silme ve boş rapor durumlarında verinin tutarlı kalmasıdır.
Bir sonraki dersimiz Fonksiyonlar olacak. Tek bir akışta büyümeye başlayan programlarımızı anlamlı parçalara ayıracak; parametre ve dönüş değeri kavramlarıyla aynı işi tekrar kullanılabilir biçimde yazmayı öğreneceğiz. Bu dersteki raporlama ve kayıt işlemleri, o konuyu öğrenirken kullanabileceğimiz somut ihtiyaçlar sunuyor.
PYTHON EĞİTİM SERİSİ · DERS 07 / 16
Yeni rehberleri kaçırmayın
Yeni teknoloji rehberleri ve pratik çözümler e-postanıza gelsin.